
Πώς η γνώση μεγάλων μοντέλων μεταφέρεται σε μικρότερα και αποδοτικότερα
Η απόσταξη γνώσης (Knowledge Distillation) επιτρέπει την ανάπτυξη μικρότερων μοντέλων Τεχνητής Νοημοσύνης, με χαμηλότερες απαιτήσεις σε υπολογιστικούς πόρους. Πώς λειτουργεί, ποια είναι τα τεχνικά όριά της και γιατί αποτελεί σημαντική τεχνολογία για την ανοιχτή ΤΝ, την έρευνα και την ψηφιακή αυτονομία της Ευρώπης;
Τι είναι η απόσταξη γνώσης στην Τεχνητή Νοημοσύνη;
Η ανάπτυξη μεγάλων γλωσσικών μοντέλων Τεχνητής Νοημοσύνης απαιτεί τεράστιες ποσότητες δεδομένων, εξειδικευμένους επεξεργαστές και σημαντική κατανάλωση ενέργειας. Ωστόσο, πολλές εφαρμογές δεν χρειάζονται ένα μοντέλο εκατοντάδων δισεκατομμυρίων παραμέτρων. Χρειάζονται ένα μικρότερο μοντέλο που να εκτελεί συγκεκριμένες εργασίες με επαρκή ακρίβεια, ταχύτητα και αξιοπιστία.
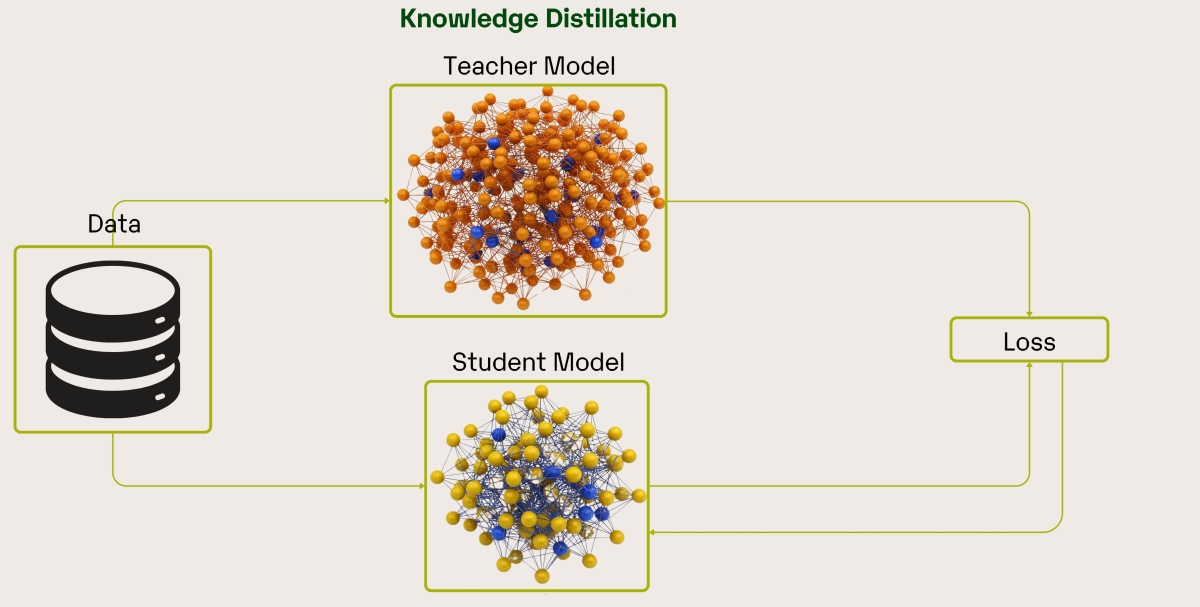
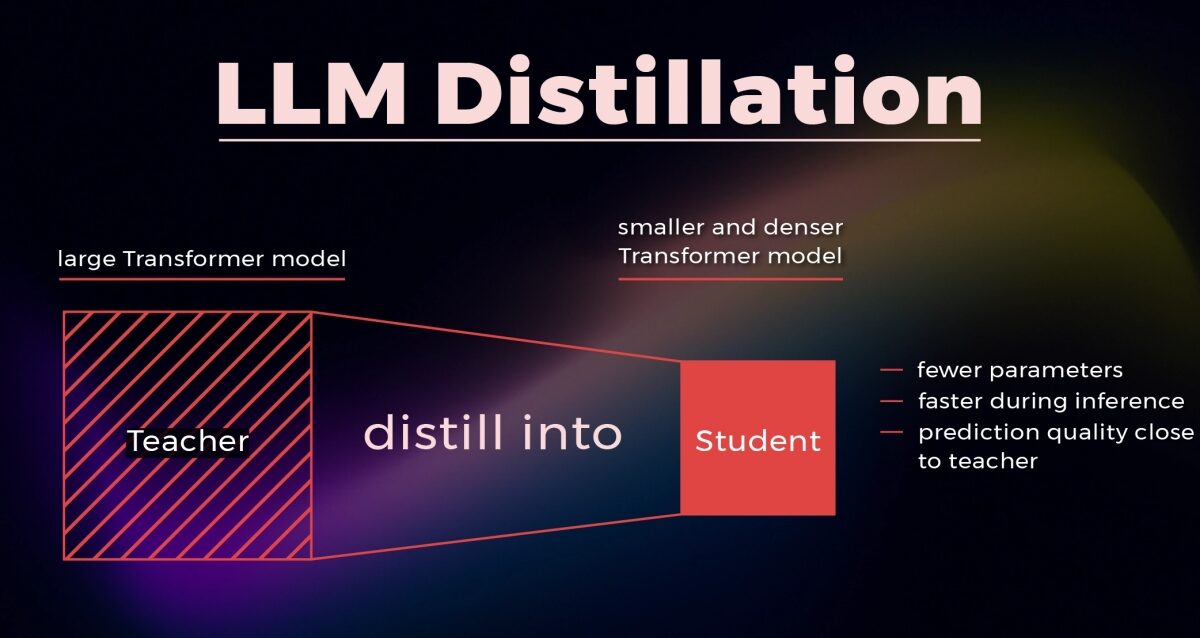
Εδώ αποκτά ιδιαίτερη σημασία η απόσταξη γνώσης (Knowledge Distillation), μια τεχνική μηχανικής μάθησης με την οποία ένα ισχυρότερο μοντέλο, ο «δάσκαλος» (teacher), χρησιμοποιείται για την εκπαίδευση ενός μικρότερου μοντέλου, του «μαθητή» (student).
Ο στόχος δεν είναι η αντιγραφή του μεγάλου μοντέλου, αλλά η μεταφορά μέρους της συμπεριφοράς και των ικανοτήτων του σε ένα μοντέλο που απαιτεί λιγότερη μνήμη, μικρότερη υπολογιστική ισχύ και χαμηλότερο λειτουργικό κόστος.
Η τεχνική δεν είναι καινούργια. Η σύγχρονη διατύπωσή της καθιερώθηκε το 2015 με την εργασία των Geoffrey Hinton, Oriol Vinyals και Jeff Dean. Με την εξάπλωση των μεγάλων γλωσσικών μοντέλων απέκτησε νέες δυνατότητες, καθώς επιτρέπει την αξιοποίηση της συμπεριφοράς ισχυρών μοντέλων για την εκπαίδευση μικρότερων.
Πώς πραγματοποιείται η απόσταξη ενός μοντέλου;
Η διαδικασία αρχίζει με την επιλογή ενός μοντέλου-δασκάλου, το οποίο παρουσιάζει υψηλή απόδοση στις εργασίες που ενδιαφέρουν τους ερευνητές. Μπορεί να είναι ένα μεγάλο γλωσσικό μοντέλο γενικής χρήσης ή ένα εξειδικευμένο μοντέλο για μαθηματικά, προγραμματισμό, νομικά κείμενα ή επιστημονική ανάλυση.
Στη συνέχεια δημιουργείται ένα σύνολο δεδομένων εκπαίδευσης. Το μοντέλο-δάσκαλος επεξεργάζεται ερωτήσεις, έγγραφα ή προβλήματα και παράγει απαντήσεις που χρησιμοποιούνται ως παραδείγματα για το μικρότερο μοντέλο.
Στην κλασική απόσταξη γνώσης, ο μαθητής εκπαιδεύεται ώστε να προσεγγίζει τις κατανομές πιθανοτήτων που παράγει ο δάσκαλος. Αυτές περιέχουν περισσότερη πληροφορία από μια απλή ένδειξη σωστής ή λανθασμένης απάντησης. Η τεχνική συχνά χρησιμοποιεί μια παράμετρο θερμοκρασίας (temperature), ώστε να αναδεικνύονται οι σχετικές πιθανότητες διαφορετικών απαντήσεων.
Στα σύγχρονα γλωσσικά μοντέλα χρησιμοποιείται επίσης η απόσταξη μέσω παραγόμενων απαντήσεων. Ο μαθητής εκπαιδεύεται πάνω σε κείμενα που έχει δημιουργήσει ο δάσκαλος, ακόμη και όταν δεν υπάρχει πρόσβαση στις εσωτερικές πιθανότητες ή στις παραμέτρους του.
Μια πιο σύνθετη εκδοχή αξιοποιεί παραδείγματα συλλογιστικής, ενδιάμεσα βήματα επίλυσης προβλημάτων και επαληθευμένες τελικές απαντήσεις. Έτσι, το μικρότερο μοντέλο μπορεί να μάθει αποτελεσματικότερες στρατηγικές επίλυσης, χωρίς αυτό να σημαίνει ότι αποκτά όλες τις ικανότητες του μεγαλύτερου.
Ακολουθούν η εκπαίδευση, ο έλεγχος σε ανεξάρτητα δεδομένα και η αξιολόγηση της συμπεριφοράς του νέου μοντέλου. Ιδιαίτερη σημασία έχουν η ακρίβεια, η αξιοπιστία, η ανθεκτικότητα σε ασυνήθιστες εισόδους και η δυνατότητα γενίκευσης πέρα από τα παραδείγματα εκπαίδευσης.
Τι κερδίζουμε και τι χάνουμε;
Το βασικό πλεονέκτημα της απόσταξης είναι ότι ένα μικρότερο μοντέλο μπορεί να προσεγγίσει την απόδοση ενός μεγαλύτερου σε επιλεγμένες εργασίες, με σημαντικά μικρότερες απαιτήσεις κατά τη χρήση του.
Αυτό διευκολύνει την εγκατάσταση μοντέλων σε πανεπιστημιακά εργαστήρια, μικρές επιχειρήσεις, δημόσιες υπηρεσίες, προσωπικούς υπολογιστές και τοπικούς εξυπηρετητές. Περιορίζει επίσης την ανάγκη διαρκούς επικοινωνίας με απομακρυσμένες υπηρεσίες ΤΝ, προσφέροντας περισσότερες δυνατότητες προστασίας δεδομένων.
Υπάρχουν όμως περιορισμοί. Ένα μικρό μοντέλο μπορεί να παρουσιάζει υψηλή απόδοση στο αντικείμενο για το οποίο εκπαιδεύτηκε, αλλά να υστερεί σε άγνωστες εργασίες, σύνθετη συλλογιστική ή εξειδικευμένη γνώση. Επιπλέον, μπορεί να κληρονομήσει σφάλματα, προκαταλήψεις και ανακριβείς απαντήσεις του δασκάλου.
Η απόσταξη δεν πρέπει να συγχέεται με την κβαντοποίηση, η οποία μειώνει την αριθμητική ακρίβεια αποθήκευσης των παραμέτρων, ούτε με το κλάδεμα παραμέτρων, που αφαιρεί επιλεγμένα στοιχεία ενός νευρωνικού δικτύου. Πρόκειται για διαφορετικές τεχνικές, οι οποίες μπορούν να συνδυαστούν.
Από τη θεωρία στην πράξη: DeepSeek και μικρότερα μοντέλα
Ένα χαρακτηριστικό παράδειγμα είναι η οικογένεια DeepSeek-R1-Distill. Οι δημιουργοί της χρησιμοποίησαν δεδομένα συλλογιστικής από το DeepSeek-R1 για να εκπαιδεύσουν μικρότερα μοντέλα, βασισμένα σε αρχιτεκτονικές Qwen και Llama, με μεγέθη από 1,5 έως 70 δισεκατομμύρια παραμέτρους.
Τα αποτελέσματα έδειξαν ότι η απόσταξη μπορεί να μεταφέρει σημαντικές ικανότητες επίλυσης μαθηματικών και προγραμματιστικών προβλημάτων σε μικρότερα μοντέλα. Δεν αποδεικνύουν όμως ότι τα μοντέλα αυτά είναι ισοδύναμα με το αρχικό σε κάθε εργασία.
Αντίστοιχα, η έρευνα γύρω από τα DistilBERT και MiniLM είχε ήδη αποδείξει ότι η απόσταξη μπορεί να δημιουργήσει συμπαγή γλωσσικά μοντέλα με ανταγωνιστικές επιδόσεις και μειωμένο υπολογιστικό κόστος.
Ανοιχτά μοντέλα, άδειες χρήσης και ψηφιακή αυτονομία
Η απόσταξη αποκτά ιδιαίτερη σημασία για την ευρωπαϊκή στρατηγική ανάπτυξης ανοιχτής Τεχνητής Νοημοσύνης.
Η πρόσβαση σε ανοιχτά βάρη μοντέλων επιτρέπει την τοπική εγκατάσταση και προσαρμογή τους. Δεν εξασφαλίζει όμως από μόνη της πρόσβαση στα αρχικά δεδομένα, στον κώδικα εκπαίδευσης ή στο δικαίωμα ανεμπόδιστης επαναχρησιμοποίησης.
Επιπλέον, όταν χρησιμοποιείται εμπορικό μοντέλο ως δάσκαλος, πρέπει να εξετάζονται οι συμβατικοί περιορισμοί χρήσης των αποτελεσμάτων του, οι άδειες των δεδομένων και τα δικαιώματα τρίτων. Η τεχνική δυνατότητα απόσταξης δεν συνεπάγεται αυτομάτως και νομική άδεια.
Για τα ευρωπαϊκά πανεπιστήμια και τους δημόσιους οργανισμούς, η προτεραιότητα πρέπει να είναι η ανάπτυξη μικρότερων, ελέγξιμων μοντέλων με τεκμηριωμένη προέλευση δεδομένων, σαφείς άδειες χρήσης, δημοσιευμένες μεθόδους αξιολόγησης και δυνατότητα ανεξάρτητης αναπαραγωγής των αποτελεσμάτων.
Μια ευκαιρία για την ελληνική γλώσσα και τη δημόσια διοίκηση
Στην Ελλάδα, η απόσταξη μπορεί να αξιοποιηθεί για τη δημιουργία εξειδικευμένων ελληνόγλωσσων μοντέλων που υποστηρίζουν την αναζήτηση νομοθεσίας, την ταξινόμηση διοικητικών εγγράφων, την εξυπηρέτηση πολιτών και την επεξεργασία επιστημονικού περιεχομένου.
Πρωτοβουλίες ανάπτυξης ελληνικών γλωσσικών πόρων, όπως το GlossAPI, μπορούν να συνεισφέρουν με κατάλληλα επιλεγμένα, καθαρισμένα και νόμιμα διαθέσιμα δεδομένα. Μεγάλα ανοιχτά μοντέλα μπορούν να λειτουργήσουν ως δάσκαλοι, ενώ μικρότερα μοντέλα μπορούν να εγκαθίστανται τοπικά σε πανεπιστήμια, δήμους και δημόσιους φορείς.
Για εφαρμογές που αφορούν δικαιώματα και διοικητικές αποφάσεις, η απόσταξη πρέπει να συνδυάζεται με αναζήτηση σε έγκυρες πηγές, συστηματική αξιολόγηση και ανθρώπινη εποπτεία.
Το ουσιαστικό ζητούμενο δεν είναι να δημιουργήσουμε απλώς μικρότερα μοντέλα, αλλά να καταστήσουμε την Τεχνητή Νοημοσύνη οικονομικά προσιτή, τεχνικά ελέγξιμη και διαθέσιμη ως κοινή ψηφιακή υποδομή. Η απόσταξη γνώσης μπορεί να αποτελέσει σημαντικό εργαλείο προς αυτή την κατεύθυνση, εφόσον συνοδεύεται από ανοιχτά πρότυπα, διαφανείς διαδικασίες και πραγματική δυνατότητα επαναχρησιμοποίησης της τεχνολογίας.
Επιστημονικές πηγές:
1. Geoffrey Hinton, Oriol Vinyals και Jeff Dean, Distilling the Knowledge in a Neural Network (2015): Η θεμελιώδης επιστημονική εργασία που καθιέρωσε τη σύγχρονη προσέγγιση της απόσταξης γνώσης. Εξηγεί πώς οι προβλέψεις ισχυρών νευρωνικών δικτύων μπορούν να χρησιμοποιηθούν για την εκπαίδευση μικρότερων και αποδοτικότερων μοντέλων. https://arxiv.org/abs/1503.02531
2. Hugging Face, DistilBERT: A Distilled Version of BERT (2019): Ένα από τα σημαντικότερα πρακτικά παραδείγματα απόσταξης γλωσσικού μοντέλου. Οι ερευνητές πέτυχαν μείωση μεγέθους κατά 40%, διατηρώντας περίπου το 97% της απόδοσης του αρχικού μοντέλου στις συγκεκριμένες δοκιμές γλωσσικής κατανόησης. https://arxiv.org/abs/1910.01108
3. DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (2025): Η τεχνική δημοσίευση περιγράφει την ανάπτυξη του DeepSeek-R1 και τη δημιουργία έξι μικρότερων μοντέλων μέσω απόσταξης, με μεγέθη από 1,5 έως 70 δισεκατομμύρια παραμέτρους. Αποτελεί σημαντικό παράδειγμα μεταφοράς ικανοτήτων συλλογιστικής σε μικρότερα γλωσσικά μοντέλα. https://arxiv.org/abs/2501.12948
4. Xiaohan Xu και συνεργάτες, A Survey on Knowledge Distillation of Large Language Models (2024): Συστηματική επιστημονική επισκόπηση των μεθόδων απόσταξης μεγάλων γλωσσικών μοντέλων, με έμφαση στη μεταφορά γνώσης, στην εξειδίκευση για συγκεκριμένες εργασίες, στην παραγωγή δεδομένων εκπαίδευσης και στις δυνατότητες ανάπτυξης μικρότερων ανοιχτών μοντέλων. https://arxiv.org/abs/2402.13116
5. Chuanpeng Yang και συνεργάτες, Survey on Knowledge Distillation for Large Language Models: Methods, Evaluation, and Application (2024): Αναλυτική επισκόπηση των τεχνικών απόσταξης, με διάκριση μεταξύ μεθόδων που απαιτούν πρόσβαση στο εσωτερικό του μοντέλου και μεθόδων που χρησιμοποιούν μόνο τις εξόδους του. Εξετάζει επίσης τις διαδικασίες αξιολόγησης, τις πρακτικές εφαρμογές και τα ανοιχτά ερευνητικά προβλήματα. https://arxiv.org/abs/2407.01885